目的
近年、ChatGPTやGeminiなどの大規模言語モデル(LLM)が急速に進化を遂げている。しかし、Microsoft Word(.docx)形式を LaTeX 文書へ正確に変換することは依然として困難であり、レイアウト崩れやエラーが発生しやすい。これは、docx が複雑な XML 構造を持つのに対し、LaTeX が意味構造中心の記述方式であることが原因である。今回の研究ではこの変換を正確に行うプロンプト・LLMの自己フィードバックの研究を行う。
実行環境
- 開発環境:Apple MacBook Air (M2) / MacOS 26.2(25C56)
- ブラウザ環境:OpenAI ChatGPT Atlas (バージョン20251212030011000 (090bdc0bb1))
- 言語モデル:OpenAI ChatGPT / GPT-5.2-Thinking
- LaTeXコンパイラ:Overleaf
検証
最低限のプロンプトで変換を行うと
以下の表をMicrosoft Wordファイルの「表を挿入」より作成し、「OverleadでコンパイルできるようLuaLaTeXに変換してください。」と言うプロンプトと共に添付を行なった。
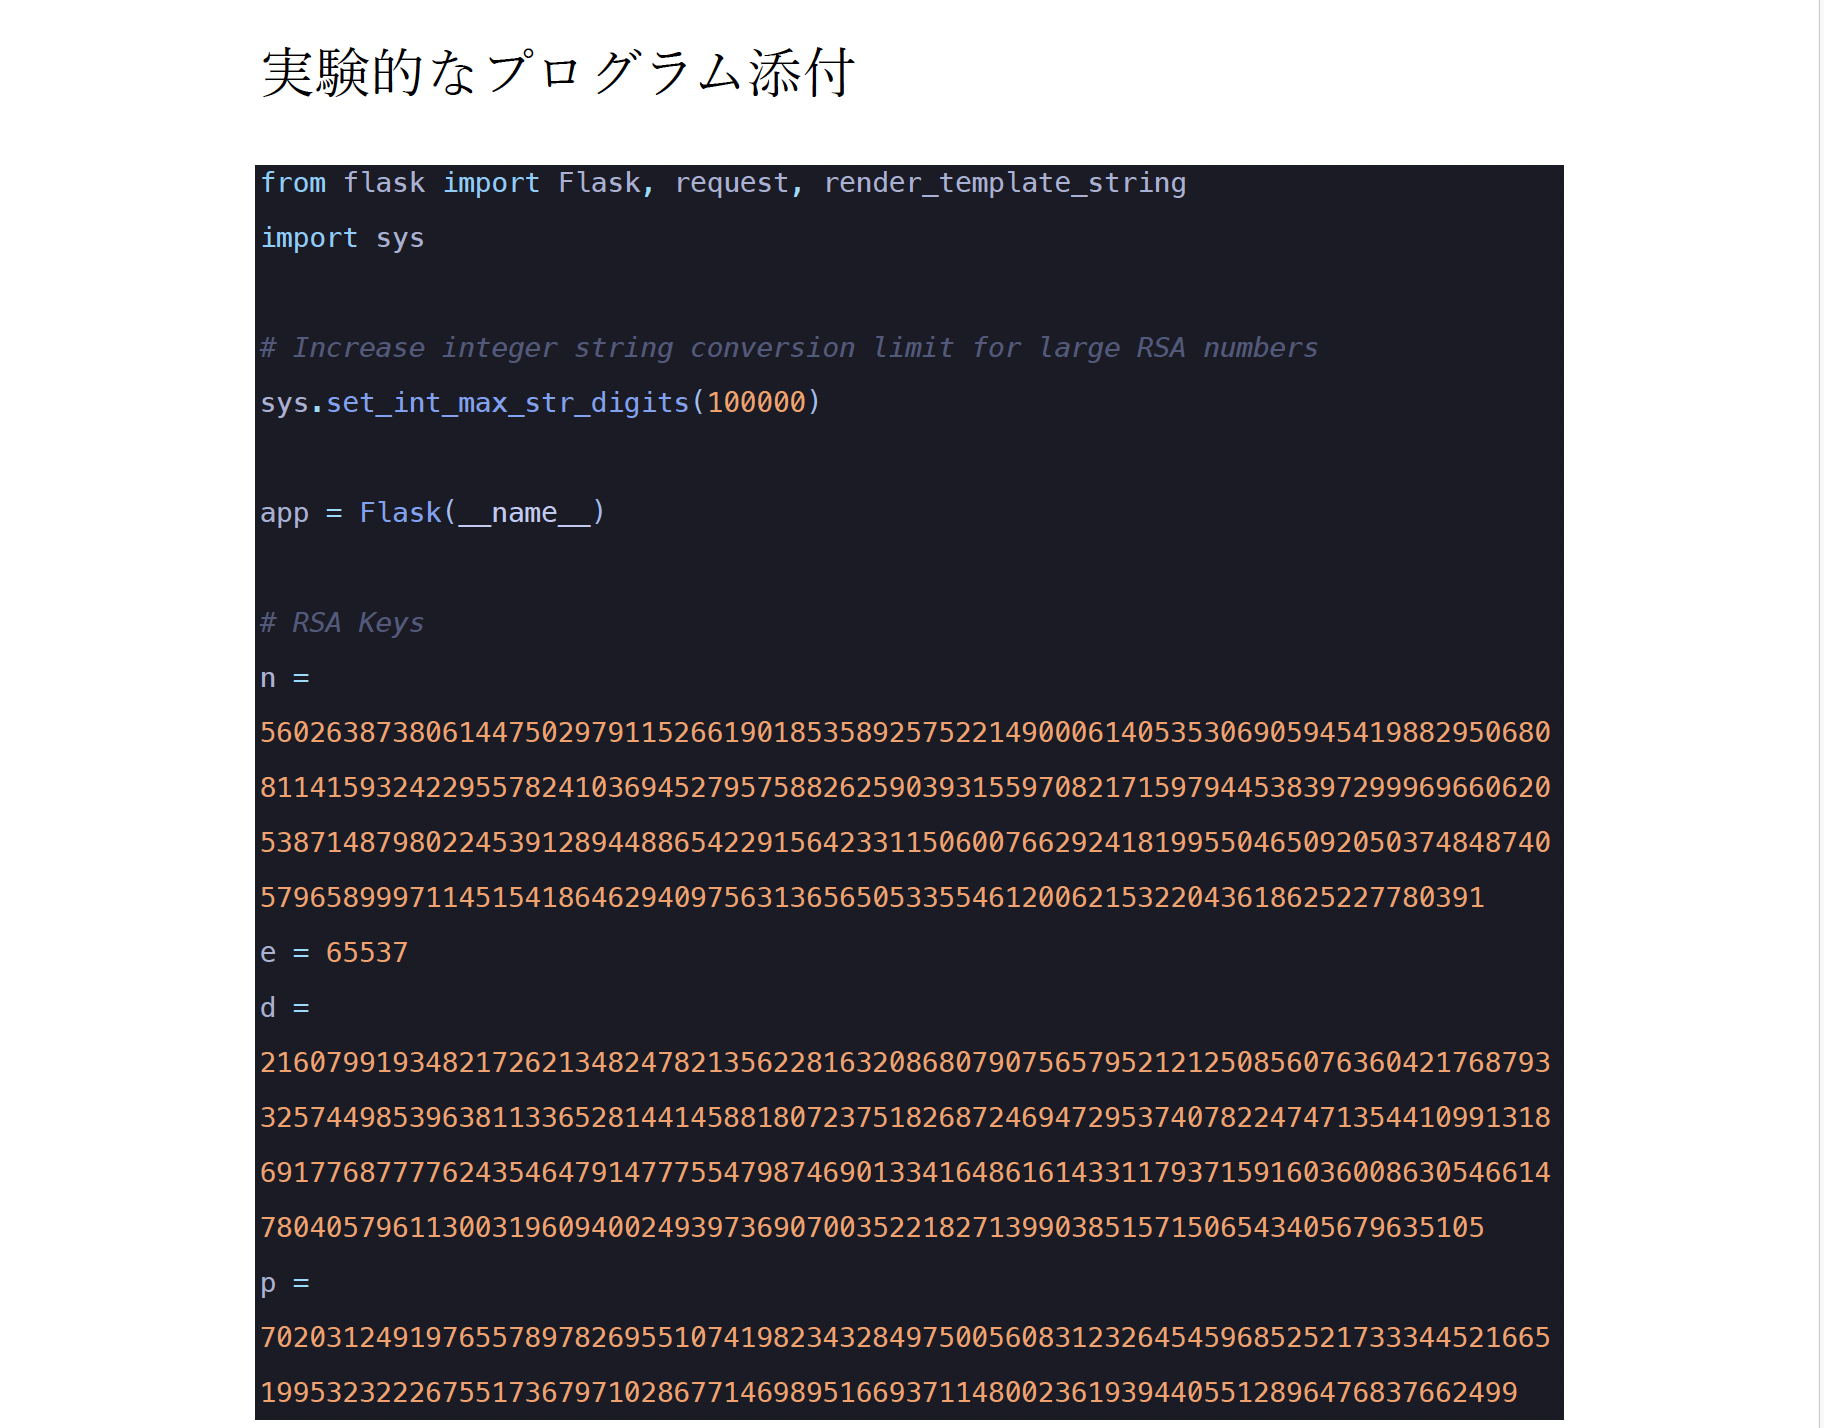
なお、今回の変換では事前に表とプログラムの添付を例としたMicrosoft Wordファイルを作成して行なっている。また、プログラムは以前の研究論文である「Antigravityの有用性について」と言う記事にて利用した公開用プログラムを使用している。
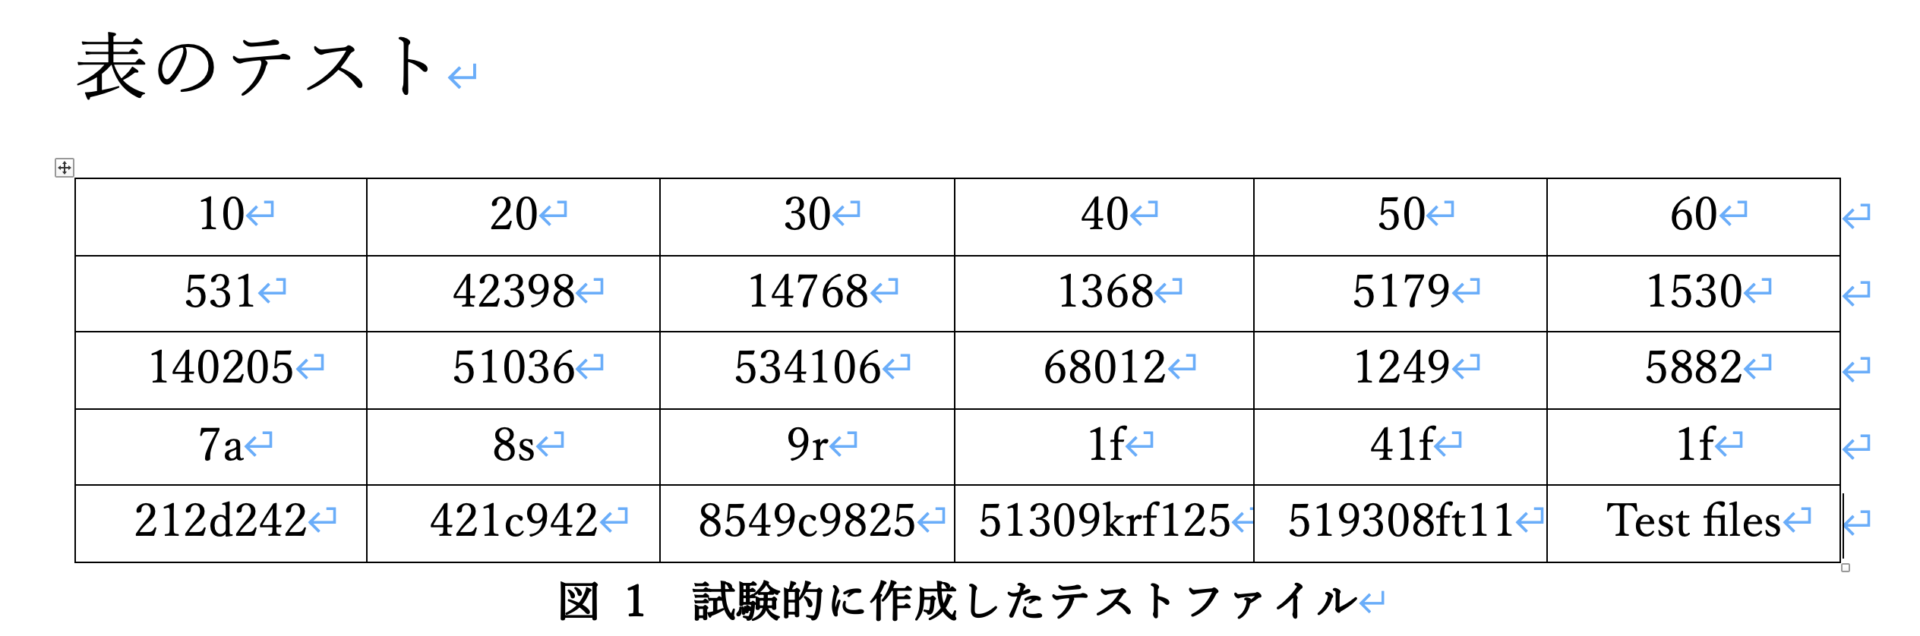
実行を行なった後、ChatGPTが1分18秒の試行時間を経てLuaLaTeX形式でプログラムが作成された。
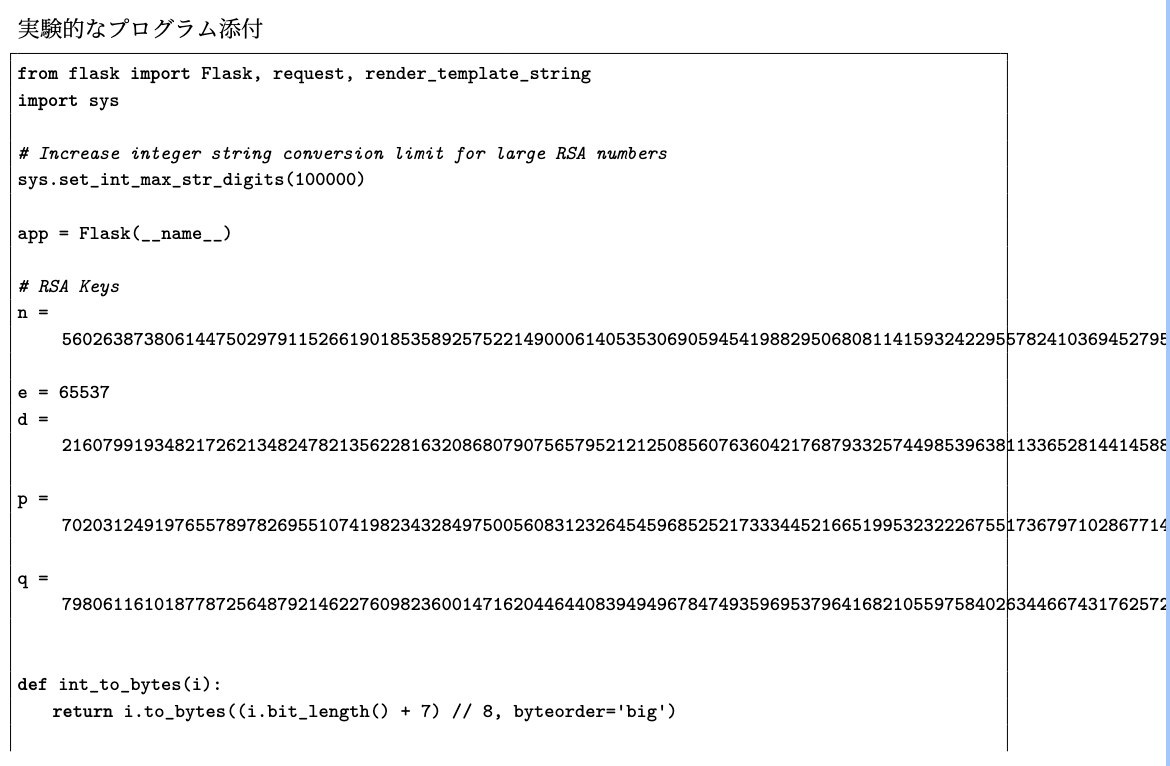
以下の結果を見て分かる通り、数字や文字等は正確に読み取ることができるが、罫線や図番号の生成が変になってしまっている。

また、プログラムの変換に関しては、左側のWordで作成したファイルと比べて右側の変換後のファイルは、枠をはみ出すなど文章として読み取ることが難しいレベルで形式が崩れてしまっている。
プロンプトにて条件定義を行なうと
前提として、ChatGPT は Word の内部構造である XML を直接解析しているわけではなく、ユーザから与えられたテキストベースの情報をもとに推論して LaTeX を生成している。このため、Word の表などは正確に把握できないことが多い。また、行列数の認識や罫線配置が不完全になる場合があり、単純な指示では tabular 環境が破損した LaTeX 表が生成される傾向がある。そのため、表等は追加でスクリーンショット等を利用してChatGPTに引き渡している。
今回は以下に記載しているプロンプトを使用して実行を行なった。
このプロンプトではレポートを書く上で最低限必要になる条件とChatGPTに「自己フィードバック」を行わせる内容が含まれている。
以下はMicrosoft Word ファイル形式で作成したのレポートです。
このファイルを元にOerleaf にてlualatex (ltjsarticle) を使用した環境で動作するLaTeX プログラム
を作成してください。

【条件定義】
- 無駄なパッケージの追加や定義を行わずに、必要最低限で記載してください。
- 図や表はスクリーンショットを読み込み、内容を再現して出力してください。罫線の位置や数字の配置など
に注意し、出力を行なってください。
- 極力エラーを減らすために構造の単純化を行なってください。
- 文の最初にスペースは入れないようにしてください。
- 全角のスペースは使用しないでください。
- 文字が枠をはみ出さないように注意してください。
- 見にくい場所などはそれぞれの場所で修正を行なってください。
- 図番号が必要な場合は図の下側に挿入、表番号が必要な場合は表の上に挿入してください。
- タイトルや名前は必要ないので実験目的から書き始めてください。
- 一つの章(1 や2.1 や4.1 などがある場合) は必ず\newpage を使用してページを切り替えてください。た
だし、section だけのページができないようにして下さい。
- 大きな章は\section を使用し、小さな章は\subsection を使用してください。なお、参考文献は専用の
コマンドを使用するのでsection 分けを行わないでください。
- item を使用する場合は\begin{itemize}のように使用してください。
- 必ずword ファイルで改行数をカウントし、文と文の間に改行が必要な場合は\vspace を使用して改行を行
なってください。また、ください。
- プログラム等は\verb||や\begin{verbatim}などを使用し、貼り付けてください。プログラムは途中で途
切れる可能性がある場合はそれぞれ次のページに配置してください。
- 参考文献に関しては\begin{thebibliography}を使用して作成を行なってください。
- LaTeX の出力が終わったら、生成したプログラムをもう一度表などを中心に読み込み直し、修正点を見つけ
次第修正を行なってください。
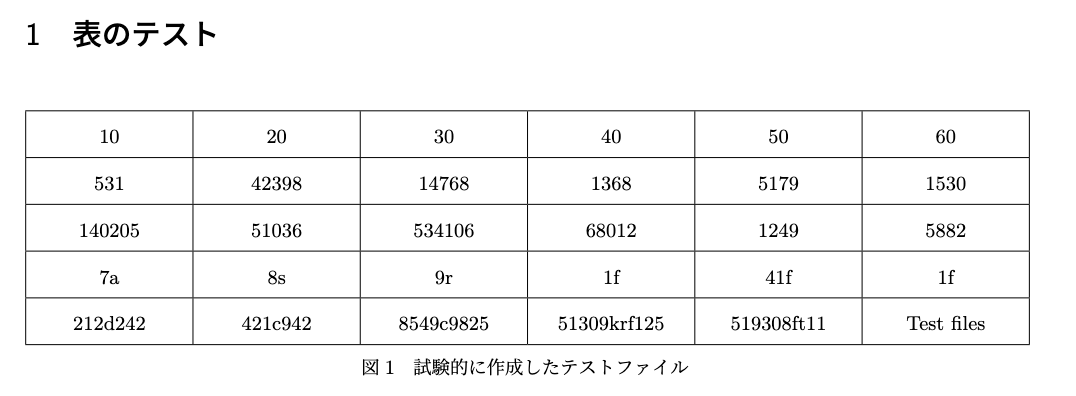
実行を行うと、\section にてセクションが作成され、中心に合わせて表が生成された。また、図番号等も問題なく正常に作成が行われている事が見て取れる。
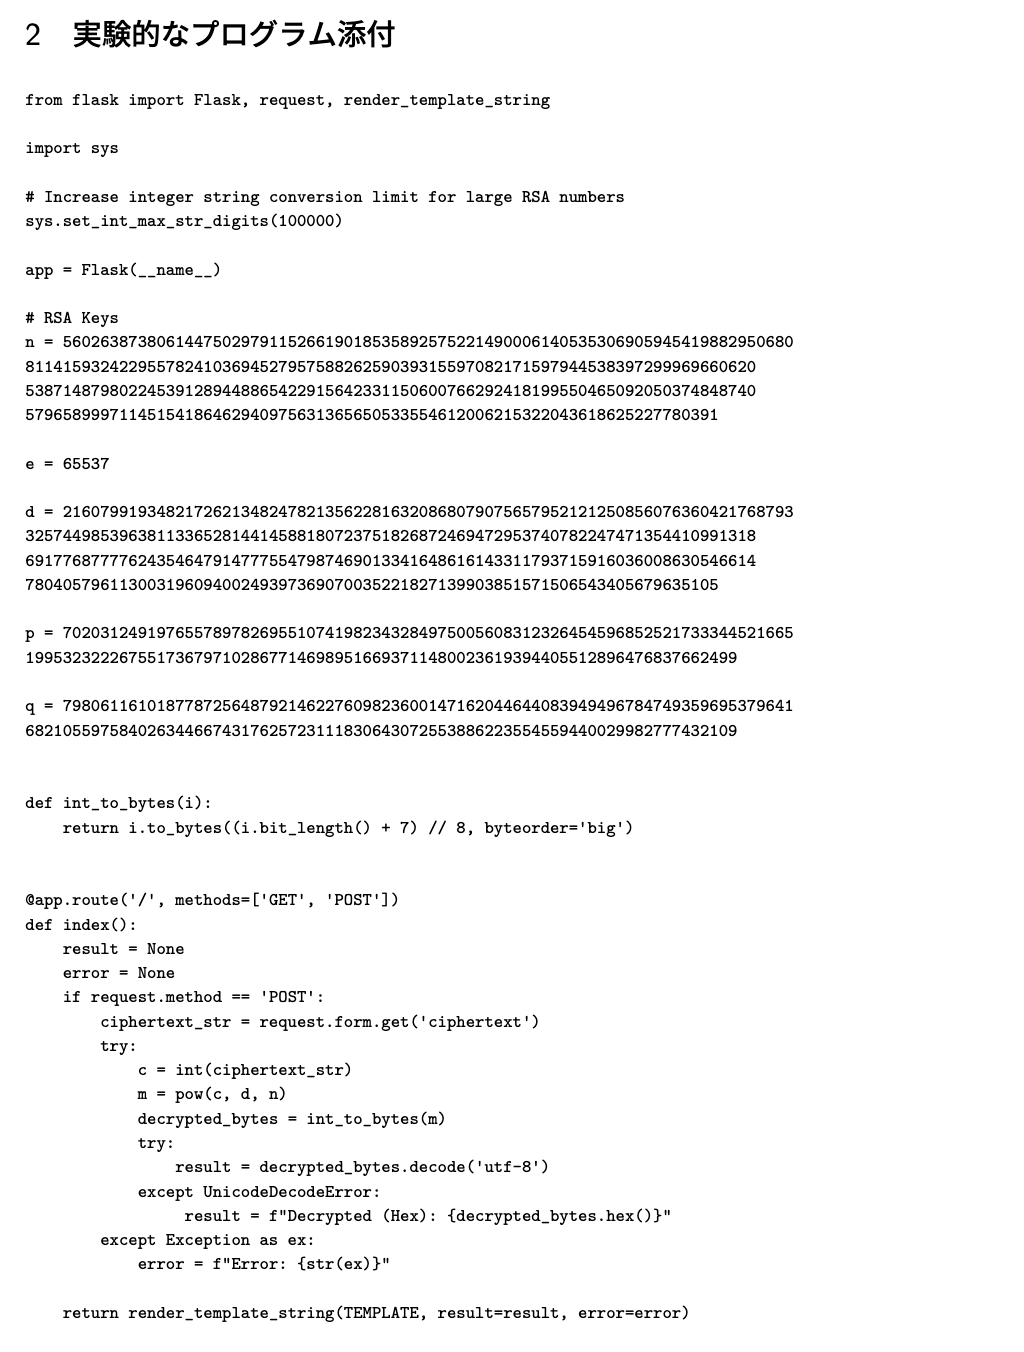
プログラムの添付もはみ出す事なく十分な余白を保持して添付が行われている。
ここまで変換が自動で行えれば実際の場面での実用性も非常に高いと思われる。
プロンプトの内容・使用法
それぞれ使用する場面で必要な定義を切り出し、ChatGPT等で使用する事ができる。
この時、ChatGPT等の大規模言語モデルは自分の出力したプログラムを自分で「本当にこのプログラムは正しいのか」を検証させる「自己フィードバック」を行わせる。そのために、プロンプトに必ず「LaTeXの出力が終わったら、生成したプログラムをもう一度表などを中心に読み込み直し、修正点を見つけ次第修正を行なってください。」と記載する。尚、この機能は「Thinking」機能は保有するAIモデルのみで利用可能であるため、ChatGPT等に課金を行っているユーザーは必ず「Thinking」モデルの選択を行う。※無料版でも自動選択で利用可能。
また、前述の通りChatGPT等はWordファイル等から表等を読み取ることが困難のため、表等を使用している場合は予めスクリーンショット等で添付を行う。
各種プロンプト例
- 入力データ・前提
- Microsoft Word(.docx)で作成したレポートを元に、Overleaf上でLuaLaTeX(ltjsarticle)で動作するLaTeXソースを作成する
- 表・プログラム添付(コード)を含む
- コンパイル環境・クラス指定
- OverleafでLuaLaTeXを使用する
- 文書クラスはltjsarticleを使用する
- パッケージ・定義の最小化
- 無駄なパッケージ追加や独自定義は行わず、必要最低限のみ使用する
- 図・表の再現要件
- 図や表はスクリーンショットを読み込み、内容を再現して出力する
- 罫線の位置、セル境界、数値の配置に注意して再現する
- 図番号が必要な場合は図の下に挿入する
- 表番号が必要な場合は表の上に挿入する
- 文字溢れ・レイアウト崩れ防止
- 文字が枠やページからはみ出さないようにする
- 長い英数字は適切に改行・折り返し・縮小を行う
- 章立て・ページ区切り
- タイトルや名前は不要とし、実験目的から書き始める
- 大きな章は\section、小さな章は\subsectionを使用する
- 一つの章が始まる場合は必ず\newpageで改ページする
- section見出しだけのページができないようにする
- 参考文献は専用コマンドを使用するためsection分けを行わない
- 改行・空行の扱い
- 文頭にスペースを入れない
- 全角スペースを使用しない
- Wordファイルで改行数をカウントし、文と文の間に改行が必要な場合は\vspaceを使用する
- 箇条書きの書式
- itemを使用する場合は\begin{itemize}…\end{itemize}を使用する
- コード・プログラムの貼り付け
- プログラム等は\verb||または\begin{verbatim}…\end{verbatim}を使用する
- プログラムが途中で途切れる可能性がある場合は分割し、それぞれ次ページに配置する
- 参考文献の形式
- 参考文献は\begin{thebibliography}…\end{thebibliography}を使用する
- 出力後の確認
- LaTeX出力後、表などを中心に読み込み直し、修正点があれば修正する
- 推奨追加条件
- 図・表は本文から極端に離れないように配置する
- 表は列幅を設計して枠内に収める
- verbatimで長行が発生する場合は手動改行または行分割で対応する
- 最終成果物はOverleafに貼り付け可能な単一の.texとする
- 特殊文字(% _ # & など)は適切にエスケープする
LLMに自己フィードバックをさせる利点
GPTに自己フィードバックをさせる利点は、初回生成で混ざりやすい誤り(体裁崩れ、要件漏れ、参照漏れ、表のはみ出しなど)を再読で拾い直し、要件遵守と品質を安定させやすい点にある。人間のレビュー前に粗い不備を減らせるため、修正回数や作業時間の削減にもつながる。
一方の欠点は、モデルが「もっともらしい説明」や「不要な修正」をしてしまい、誤りを温存したまま体裁だけ整えることがある点である。また、修正の過程で原資料の忠実再現や制約条件から外れたり、コストや出力が増えて冗長化したりするリスクもある。
自己フィードバックに関する研究
今回はプロンプト1つでChatGPT等に「自己フィードバック」を行わせる研究を行なった。
この単一プロンプトで自己フィードバックを行わせる事例としては過去に詳しい研究が行われており、今回の方法と同様に初回出力でフィードバックを求める方法が利用されていた。これらの方法では従来のシンプルなプロンプトの出力と比較しても平均20%以上の性能向上性が示されている。
Self-Refine(単一プロンプト+評価誘導)
Self-Refineは、追加の訓練や外部データなしで、同じLLMに初回出力のフィードバックを求め、それを改善に反映させる方式を提案した研究です。初回アウトプットに対して自己評価・改善のプロンプトを与えることで、従来の一発出力と比較してタスクパフォーマンスが平均20%程度向上することが示されました。
参考文献
A. Madaan,N. Tandon,P. Gupta,K. Hall,J. Gao,P. Clark,
「Self-Refine:自己フィードバックによる反復的改善手法」,
arXiv preprint arXiv:2303.17651,2023年.


